CPU 和 GPU 有什么不一样?
《一张照片是怎么存进手机里的?》讲了,比特是怎样存下来的。可存下来还不够,照片要显示、要美颜,视频要播放,人工智能要回答问题,这些都要「算」。手机和电脑里负责算的,主要是两块芯片:CPU(中央处理器)和 GPU(图形处理器)。
GPU 本来是给游戏画画面的,今天却成了训练人工智能的主力。它和 CPU 到底有什么不一样?两块芯片都是由同样的晶体管做成的,为什么擅长的事情差这么多?
先猜一猜
常见的说法有两种:
- 「GPU 比 CPU 更快。」不完全对。有的事情 GPU 快得多,有的事情 CPU 快得多。
- 「GPU 就是专门管显示的。」最初是这样,可今天世界上最强的 GPU,大多根本不接显示器,而是在数据中心里训练人工智能。
晶体管:会发热的开关
CPU 和 GPU 都由晶体管组成,就是《一张照片是怎么存进手机里的?》里那种小开关,只是没有那个存电子的「小岛」:栅极加上电压,开关就通;撤掉电压,开关就断。把开关连起来,就能做加法、比大小,再复杂的计算,归根到底都是一大堆开关在一通一断。
芯片里有一个「时钟」,每「滴答」一下,开关们就翻动一次。每秒滴答 30 亿次,就是 3 GHz。
一次滴答有多短?3 GHz 时只有 0.33 纳秒,光在这段时间里只能走 10 厘米。计算机先驱格蕾丝·霍珀讲课时,常常给听众每人发一根 30 厘米长的电线:这就是「一纳秒」,光在一纳秒里走的距离。
芯片里的信号可比光慢得多。导线里的电子本身几乎不动,每秒只挪不到 1 毫米;沿着导线传过去的,是电场。在理想的导线里,电场的变化能以光速的一半左右传播;可芯片上的导线细得只有几十纳米,电阻很大,信号每往前走一段,都要先通过这段电阻,把导线和周围构成的「电容」充上电,就像隔着一根很细的管子往一长串水桶里灌水。导线越长,要充的电越多、电阻也越大,延迟按长度的平方增长。所以长导线每隔一段就要加一个「中继」放大一下,就算这样,信号每走 1 毫米也要几十皮秒,只有光速的几十分之一到十分之一左右。
一次滴答里,信号要从一组开关出发,穿过十几到二十层开关的运算,赶在下一次滴答前到达。时钟越快,留给这段路的时间越少,所以一个核心要做得很紧凑,常用的数据也要放在核心旁边。一块芯片约 1 到 3 厘米宽,信号从一边走到另一边要好几次滴答;到主板上的内存条取一次数据,要几十到一百纳秒,相当于两三百次滴答。所以芯片里要专门放一块「缓存」,把常用的数据留在手边。
开关每翻动一次,都要给一个极小的电容充电、放电:充一次电,要用掉约 的能量( 是电容, 是电压),放电时这些能量就变成了热。所以一块芯片的发热,大约是
是时钟频率, 是每次滴答实际翻动的开关比例。滴答越快,开关越多,电压越高,发热就越多。
越做越小,频率却不再上涨
几十年来,工程师把晶体管越做越小。1974 年,IBM 的登纳德等人指出:晶体管缩小一半,电容也变小,电压也可以降低,每个开关的发热就少得多,于是可以在同样大的芯片上放更多晶体管、跑更快的时钟,总发热却不变。这让芯片的频率从 1971 年的不到 1 MHz,一路涨到 2000 年代初的 3 GHz 以上。
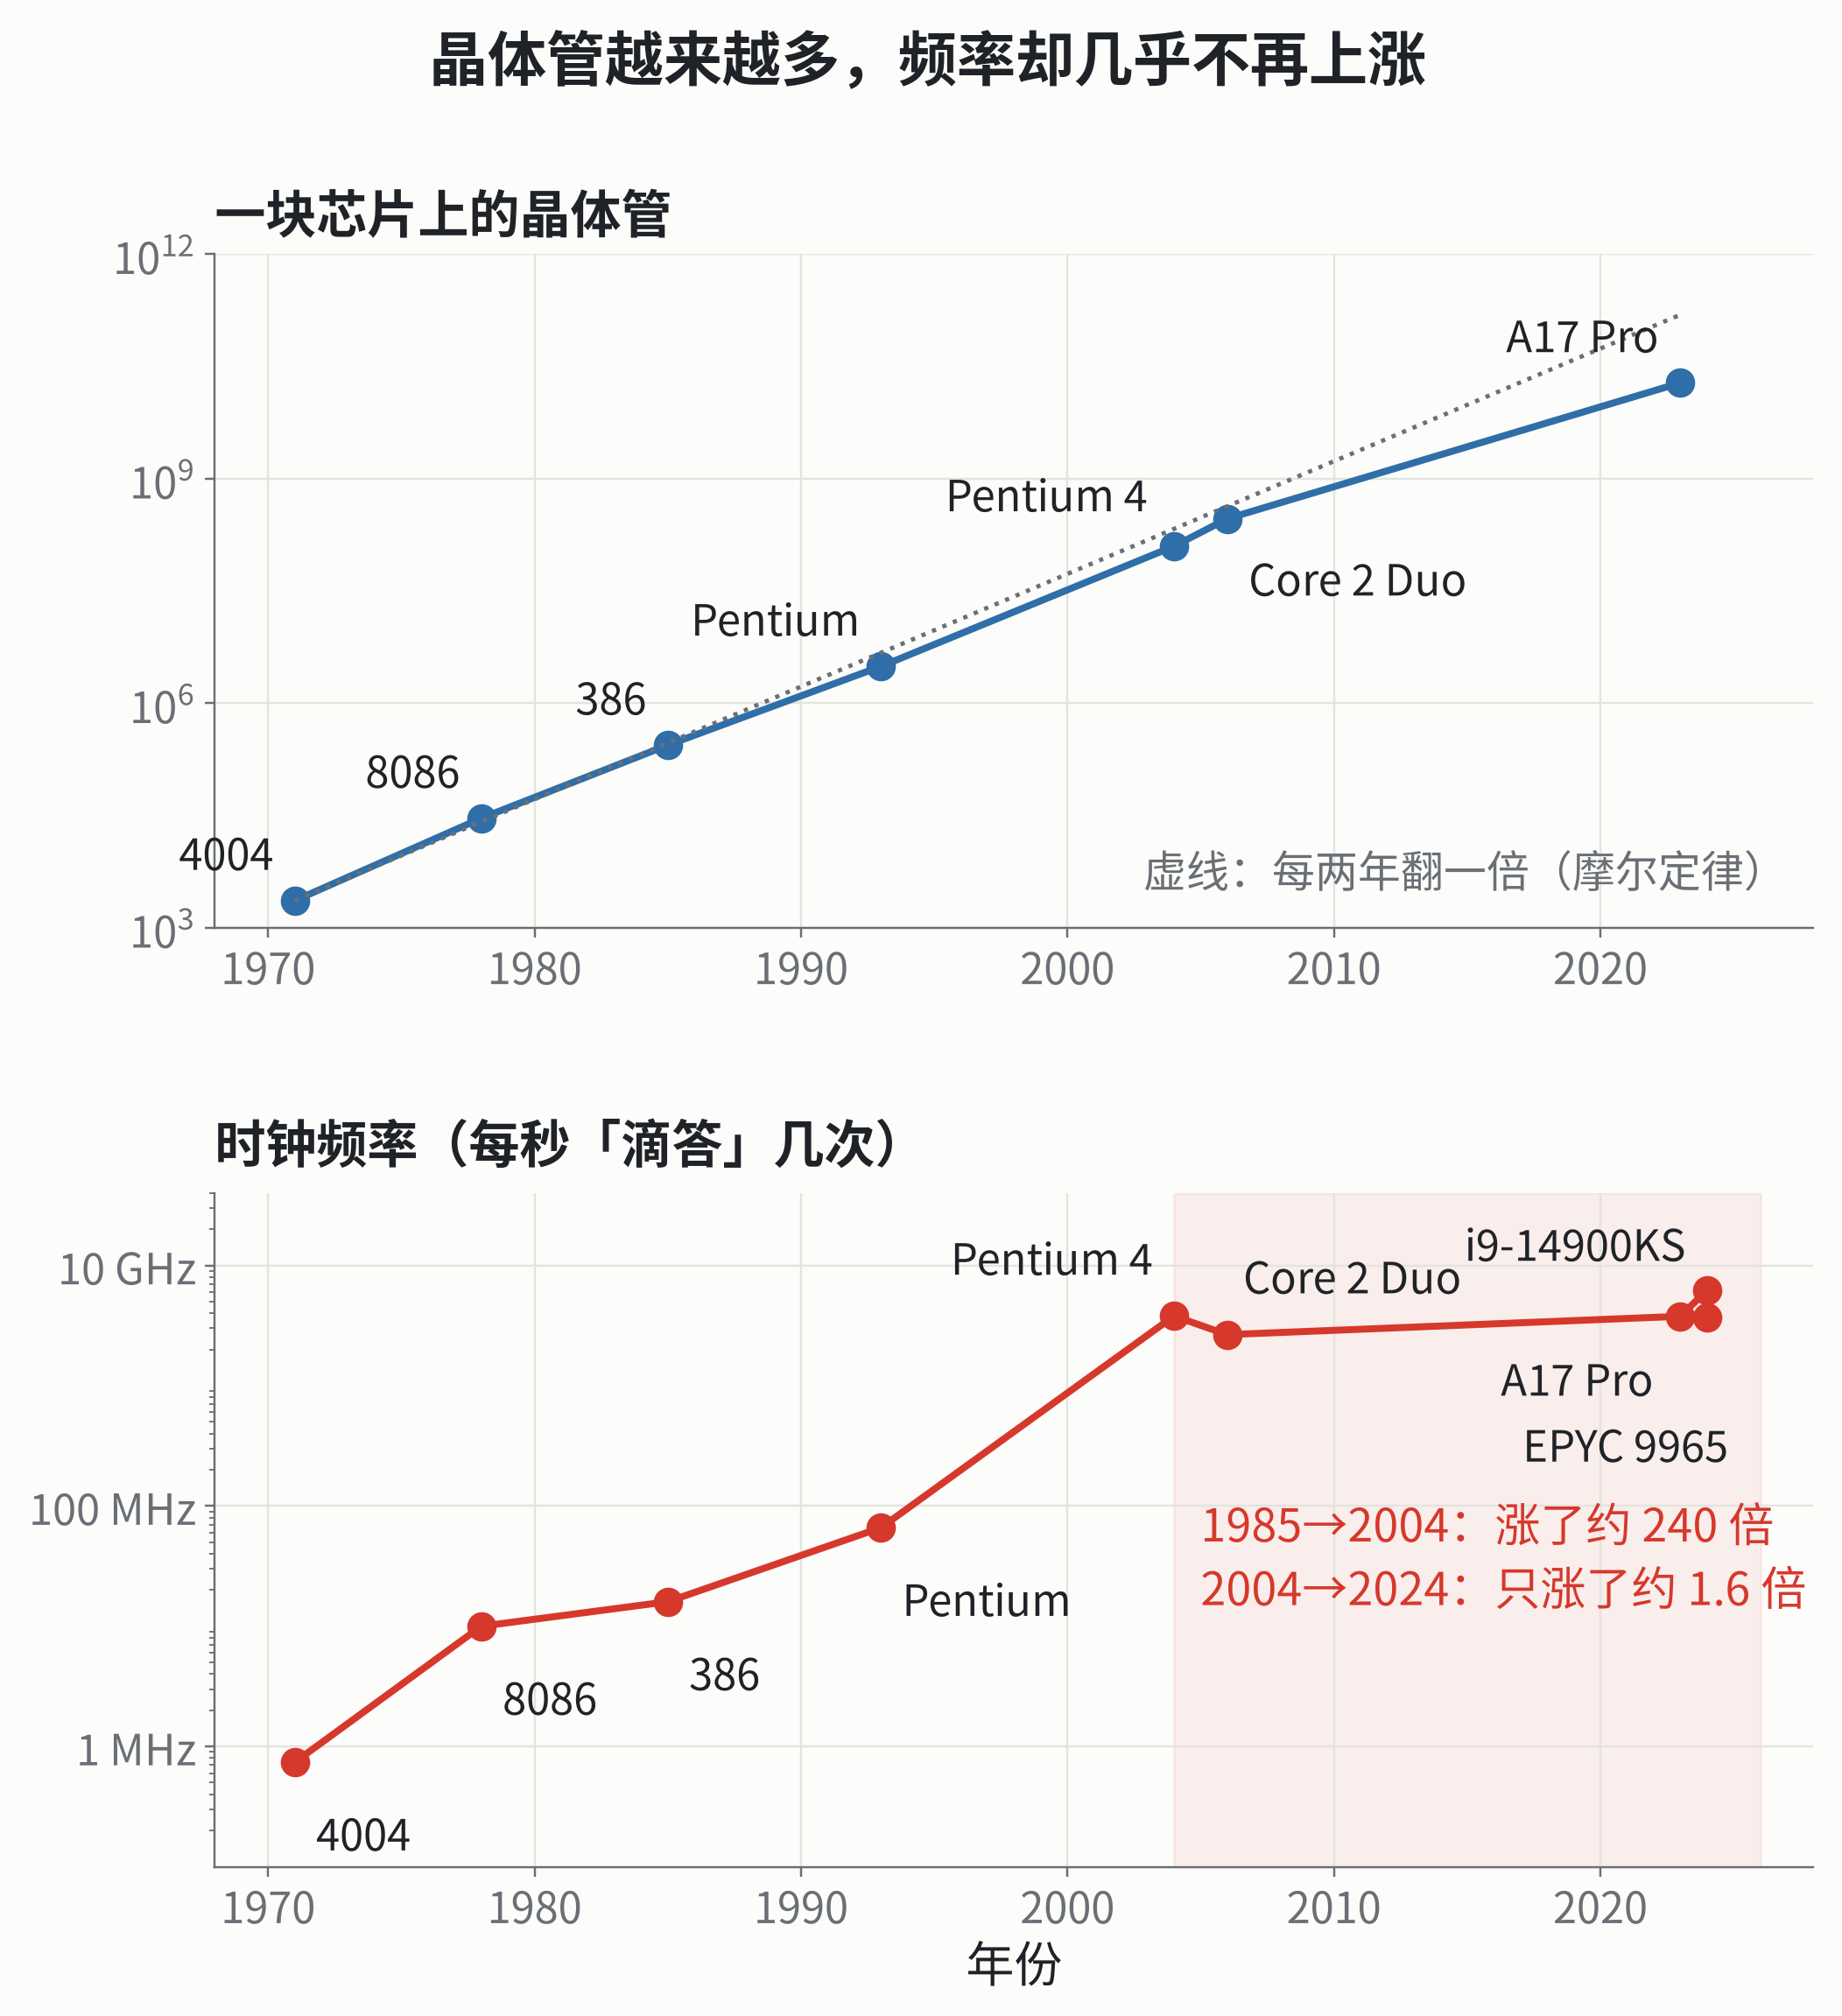
可到了 2004 年前后,频率的增长停住了。2000 年英特尔推出奔腾 4 时,曾说这种设计能做到 10 GHz;2004 年 10 月,它却取消了 4 GHz 的版本,最高停在 3.8 GHz。英特尔没有公布具体原因,只说要把工程师转去做双核芯片;当时普遍的分析是:3.8 GHz 的奔腾 4 已经要耗电约 115 瓦,再快,发热就超出了一台普通电脑能散掉的范围。
此后二十年,频率只涨了一点:2024 年最快的台式机芯片酷睿 i9-14900KS,最高 6.2 GHz,而且只是一两个核心在短时间里「冲刺」;手机芯片多在 4 GHz 上下,数据中心的芯片常常只有 2 到 4 GHz。对比此前的 1985 年到 2004 年,频率涨了约 240 倍。
原因是电压降不下去了。晶体管有一个「门槛电压」,栅极电压高过它,开关才通。门槛电压越低,开关就越容易「关不严」:硅里的电子在热运动,有快有慢,总有一些能量够大的电子翻得过门槛,形成漏电。按玻尔兹曼分布,室温下门槛每降低约 0.06 伏,关着时的漏电就至少多 10 倍(真实的晶体管更差一些)。门槛降不了,工作电压也就只能停在 1 伏上下。
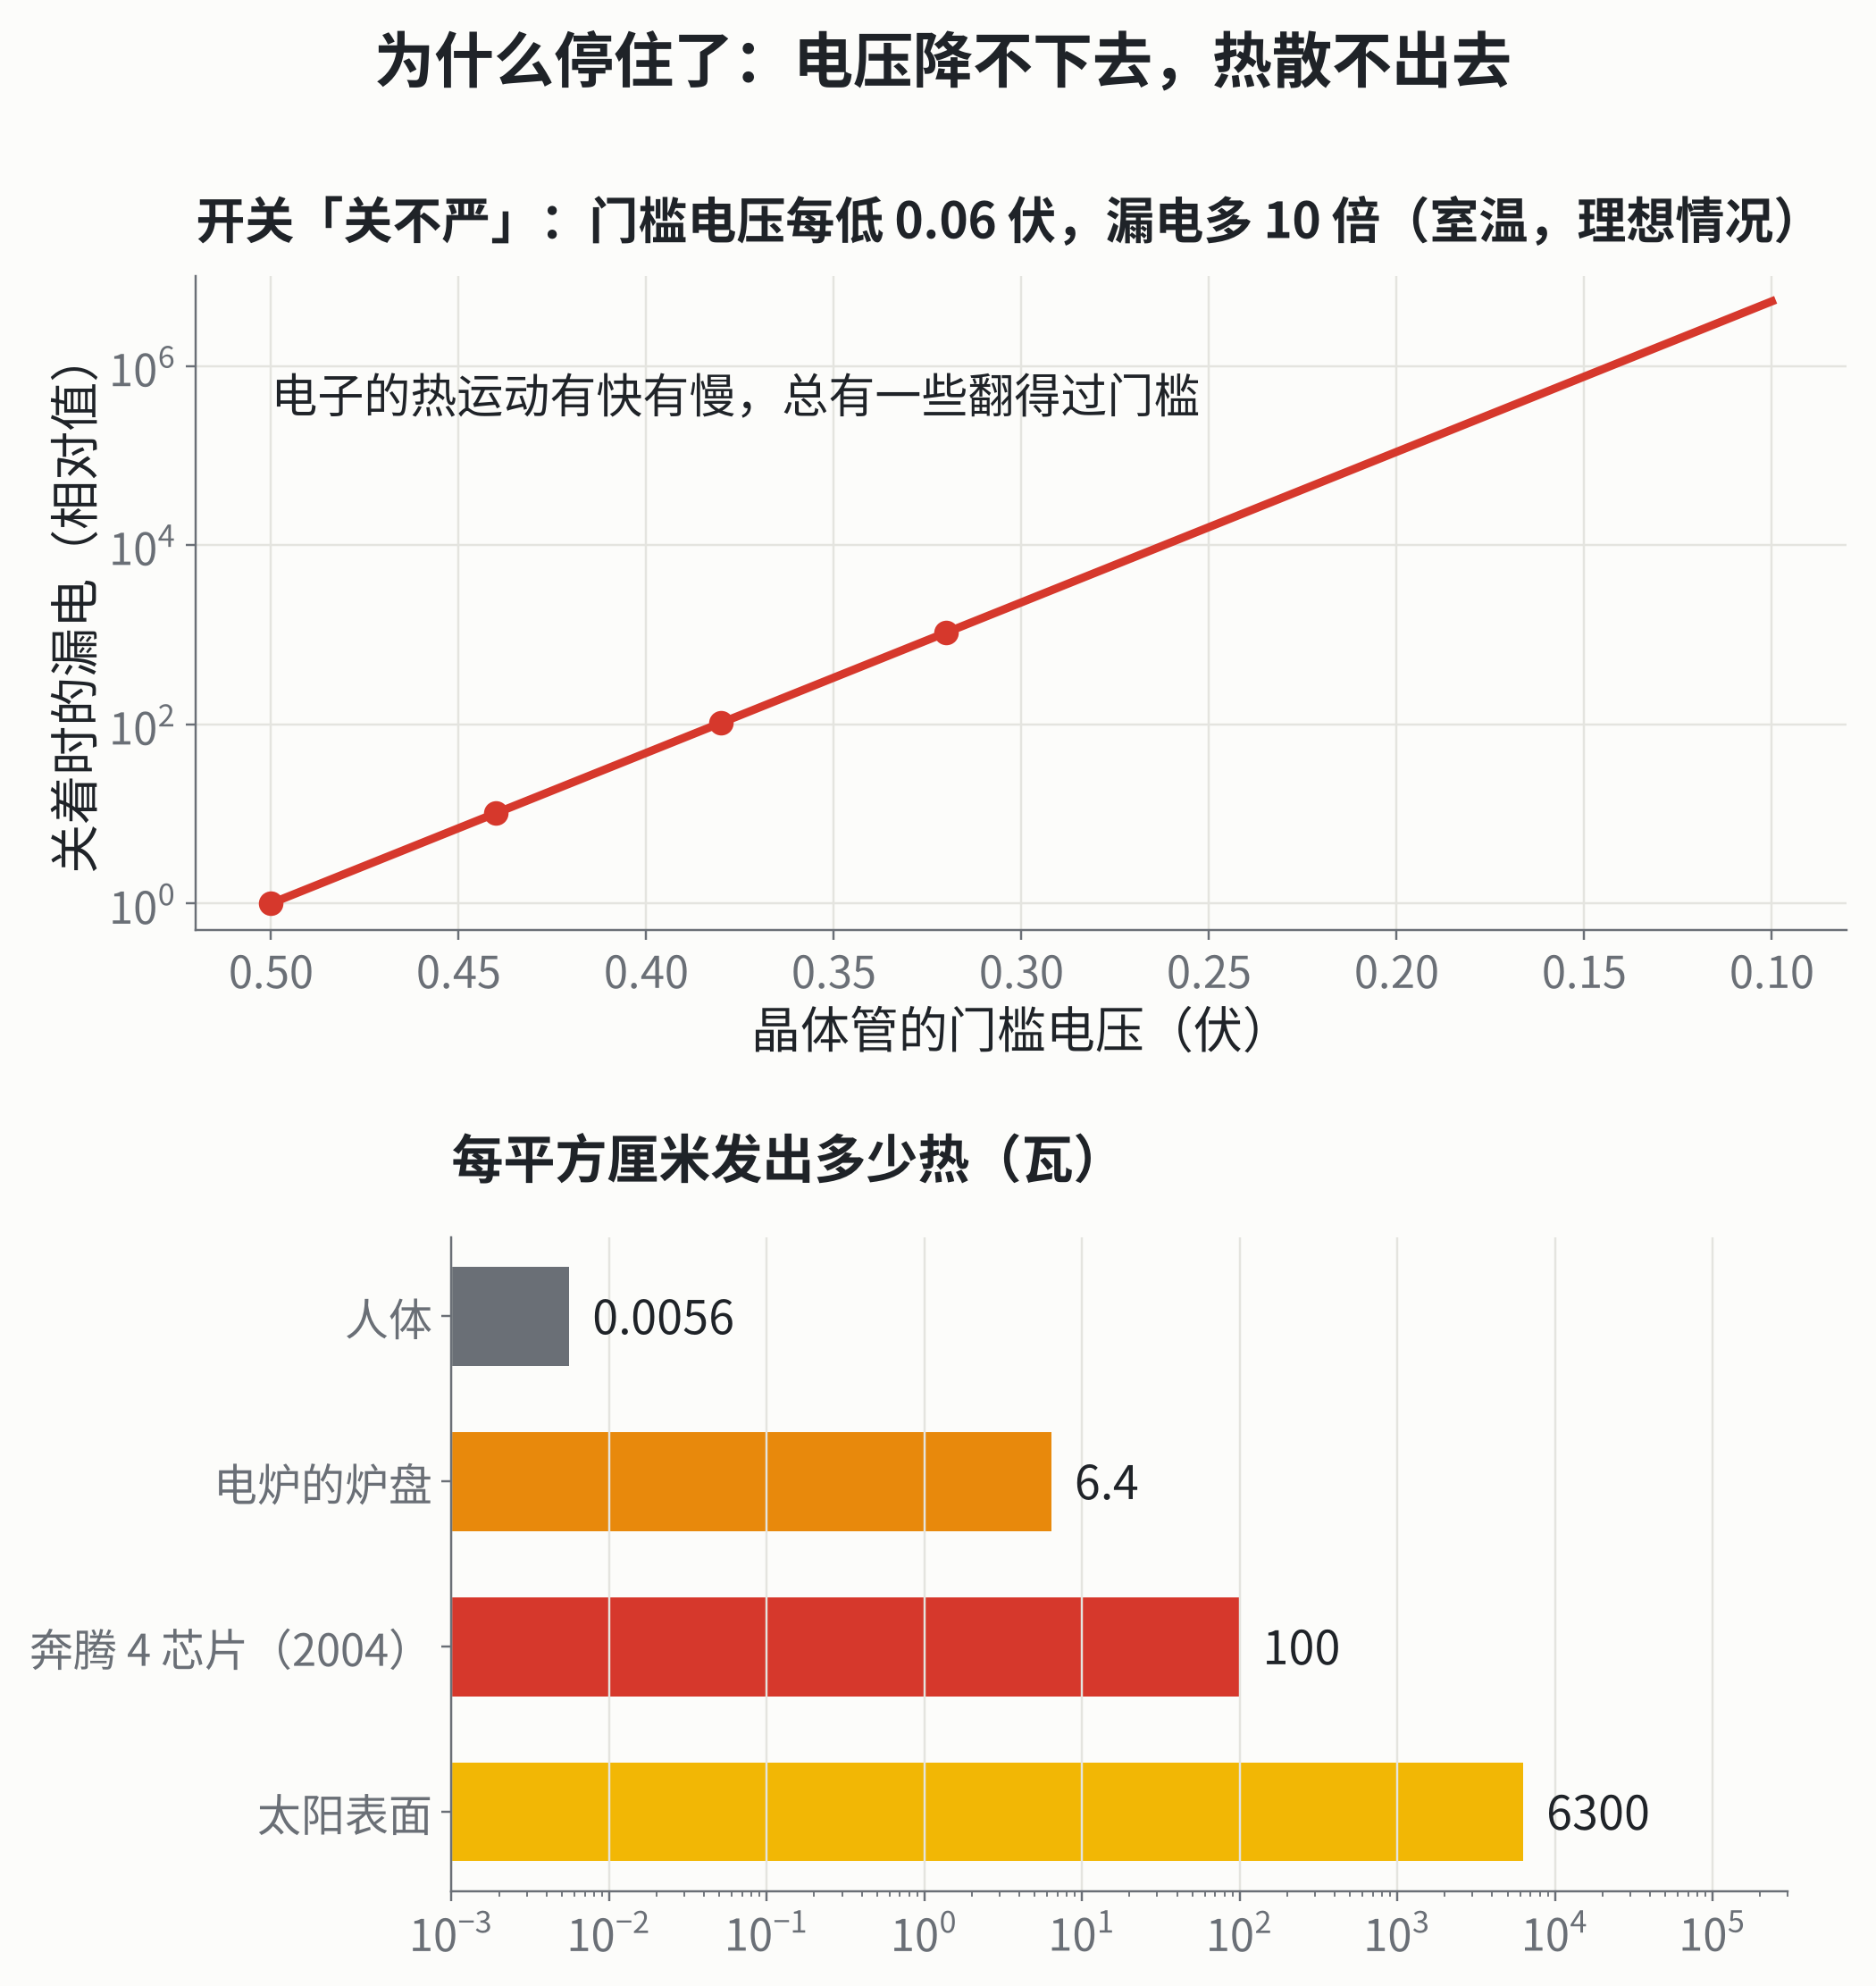
电压不降,频率再往上提,发热就跟着往上涨。芯片本身并不大:一块电脑芯片约 1 到 3 平方厘米,指甲盖大小;最大的 GPU 芯片也只有约 8 平方厘米,这是光刻机一次能做出的最大面积。奔腾 4 的芯片约 1.1 平方厘米,满负荷时约 115 瓦,平均每平方厘米约 100 瓦,是电炉炉盘的十几倍;2022 年的 H100 芯片约 8 平方厘米、700 瓦,每平方厘米也有约 86 瓦。热要先传到金属盖、再传到散热片上,靠风扇或水带走。再快,就散不出去了。
两条路:几个快的,还是很多慢的?
频率涨不上去,晶体管却还在越来越多。怎么用?答案是把一个核心变成好几个核心,一起干活。理想情况下,这笔账很划算:如果频率降低 20%,电压也能跟着降低 20%,每个核心的发热就只剩约一半(),两个这样的核心加起来,比原来一个核心快 60%,发热却差不多。实际上电压降不了这么多,漏电也还在,账没有这么漂亮,但方向是对的。
2005 年,英特尔和 AMD 都推出了双核的个人电脑芯片。2006 年的酷睿 2 双核,频率比奔腾 4 低,可每个核心在一次滴答里能做更多的事,结果比奔腾 4 更快,功耗只有 65 瓦。
可核心不是越多越好。一件事里总有一部分只能一步接一步地做,这部分再多核心也帮不上忙。设能分给大家一起做的比例是 ,用 个核心,最多快到
倍,这叫阿姆达尔定律。哪怕 95% 的工作都能分,核心再多,也最多快 20 倍:剩下那 5% 成了瓶颈。
从这里开始,CPU 和 GPU 走上了两条路:
- CPU 只有几个到几十个核心,可每个都又快又「聪明」:能猜下一步要走哪条路、提前把数据准备好、把指令打乱了按最快的顺序做。它擅长一步接一步、处处要做判断的工作,比如运行操作系统、打开网页。
- GPU 有成千上万个简单的核心,每个都慢一些、笨一些,可它们同时干同一种活。它擅长「同样的事做千千万万遍」,比如给几百万个像素各自算颜色。
所以,GPU 适合 几乎等于 1 的事情。一个画面有几百万个像素,每个像素的颜色都可以各算各的,正是 GPU 的拿手活。1996 年,3dfx 公司的 Voodoo 显卡让 3D 游戏在个人电脑上流行起来;1999 年,英伟达把画 3D 画面的几道工序都集成到一块芯片上,推出 GeForce 256,称之为「第一块 GPU」。
GPU 怎样走向人工智能
2006 年,英伟达推出 GeForce 8800 GTX,同时公布了 CUDA:程序员可以用它让 GPU 算任何东西,而不只是画画面。
人工智能里最多的计算,是矩阵乘法:把一大张表里的数和另一大张表里的数一一相乘、再相加。结果里的每一个数,都可以各算各的,又是 GPU 的拿手活。2012 年,多伦多大学的克里热夫斯基、苏茨克维和辛顿,用两块游戏显卡 GTX 580 训练了五六天,做出了一个叫 AlexNet 的神经网络,在图片识别比赛里错误率只有 15%,第二名是 26%。这被看作今天这一轮人工智能热潮的起点。
2024 年,辛顿和霍普菲尔德获得诺贝尔物理学奖,理由是「为利用人工神经网络进行机器学习做出的基础性发现和发明」。辛顿 1985 年和同事提出的「玻尔兹曼机」,用的正是前面讲漏电时的那个玻尔兹曼分布:统计物理里描述大量粒子的工具,成了人工神经网络的基础。
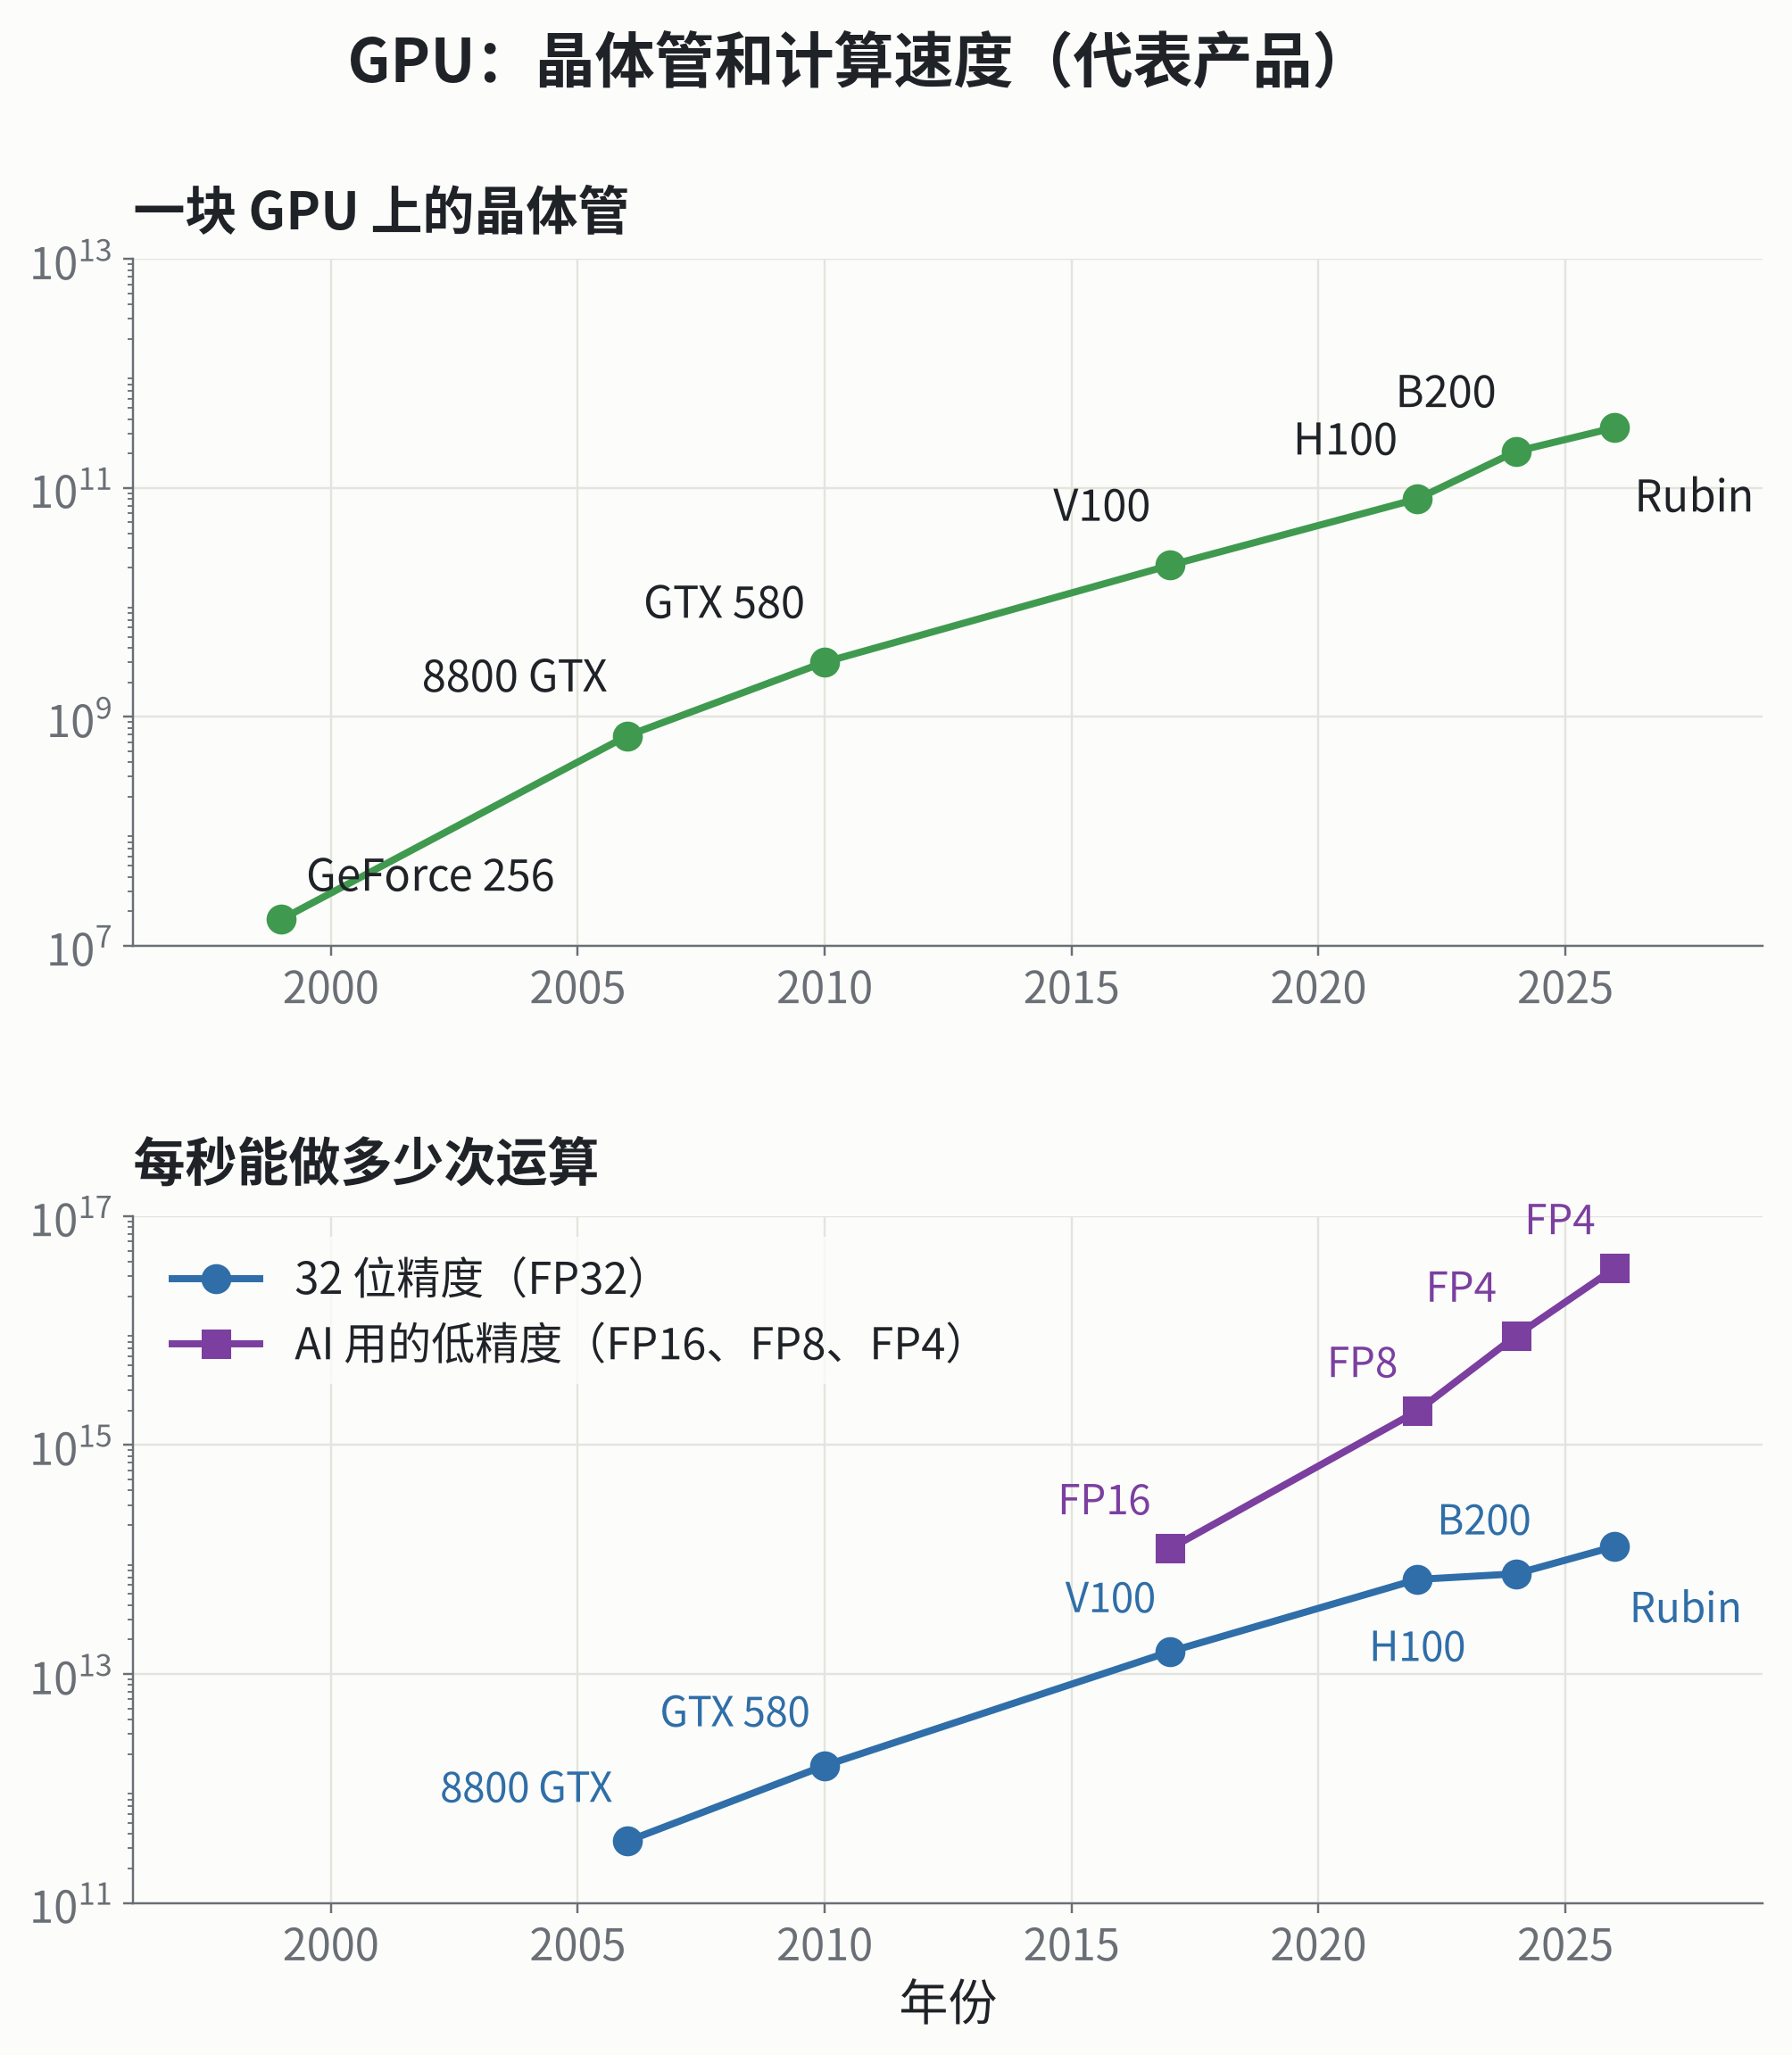
从 2017 年的 V100 开始,GPU 里加进了专门做矩阵乘法的「张量核心」,一次就能算完一小块矩阵。AI 还不需要很高的精度:普通计算用 32 位(FP32)存一个数,约有 7 位有效数字;AI 常用 16 位、8 位,甚至 4 位(FP4),4 位只能表示十几个不同的数。位数少,乘法器里要翻动的开关就少得多,同样的能量就能多算很多次。
一张表:半个世纪的代表芯片
CPU
| 年份 | 芯片 | 工艺 | 晶体管 | 频率 | 核心 | 意义 |
|---|---|---|---|---|---|---|
| 1971 | 英特尔 4004 | 10 微米 | 0.74 MHz | 1 | 第一块商用单芯片微处理器,为一家日本计算器公司设计 | |
| 1978 | 英特尔 8086 | 3 微米 | 5–10 MHz | 1 | 今天电脑里 x86 指令的源头 | |
| 1985 | 英特尔 386 | 1.5 微米 | 16–33 MHz | 1 | 32 位 | |
| 1993 | 奔腾 | 0.8 微米 | 60–66 MHz | 1 | 一次能执行两条指令 | |
| 2004 | 奔腾 4(Prescott) | 90 纳米 | 3.8 GHz | 1 | 频率冲到 3.8 GHz,约 115 瓦;4 GHz 版本被取消 | |
| 2006 | 酷睿 2 双核 E6700 | 65 纳米 | 2.66 GHz | 2 | 频率降下来,核心多起来,65 瓦 | |
| 2023 | 苹果 A17 Pro | 3 纳米 | 3.78 GHz | 6 | 手机芯片,CPU、GPU、神经网络引擎在一块芯片上 | |
| 2024 | 英特尔酷睿 i9-14900KS | Intel 7 | 未公布 | 3.2–6.2 GHz | 24 | 台式机芯片,最高频率只在一两个核心上短时达到;基础功耗 150 瓦 |
| 2024 | AMD EPYC 9965 | 3 纳米 | 未公布 | 2.25–3.7 GHz | 192 | 数据中心用的服务器芯片,500 瓦 |
GPU
| 年份 | 芯片 | 晶体管 | 每秒运算(FP32) | AI 低精度(每秒) | 功耗 | 意义 |
|---|---|---|---|---|---|---|
| 1999 | GeForce 256 | — | — | — | 英伟达称之为「第一块 GPU」 | |
| 2006 | GeForce 8800 GTX | — | 155 瓦 | 第一块能用 CUDA 做通用计算的 GPU,128 个核心 | ||
| 2010 | GTX 580 | — | 244 瓦 | 两块训练出 AlexNet,512 个核心 | ||
| 2017 | V100 | (FP16) | 300 瓦 | 第一次加入张量核心,5120 个核心 | ||
| 2022 | H100 | (FP8) | 700 瓦 | 大语言模型时代的主力 | ||
| 2024 | B200 | (FP4) | 1000 瓦 | 两块芯片封装在一起 | ||
| 2026 | Rubin | (FP4) | 未公布 | 3 纳米,2026 年开始出货 |
几个数字放在一起看:
- 你口袋里的手机芯片 A17 Pro,晶体管是 1971 年 4004 的约 800 万倍。
- 一块 Rubin 用 4 位精度,每秒约 次运算。全世界 82 亿人每人每秒算一次,要算约 50 天才赶得上它 1 秒。
- 一块 B200 约 1000 瓦,和一台微波炉差不多,却集中在十几平方厘米的芯片上,要靠巨大的散热片和强风来冷却,很多机房干脆改用液体冷却。
算一次,最少要花多少能量?
芯片用掉的电,最后几乎全都变成了热:算出来的结果只是几个比特,本身并不「装」着能量。那么,计算是不是一定要发热?最少要发多少?
1961 年,IBM 的物理学家兰道尔想清楚了这件事:算的过程中要不断擦掉旧的比特,而擦掉 1 个比特,至少要向周围放出 的热( 是玻尔兹曼常数, 是温度)。道理和热力学第二定律相同:一个比特原来可能是 0 也可能是 1,擦掉以后只剩一种状态,这份「不确定」不会凭空消失,只能以热的形式交给周围。室温下,这个下限约 焦。2012 年,法国里昂的物理学家用激光「镊子」夹住一颗微米大的小球,让它代表一个比特,第一次在实验里量到了这个下限。
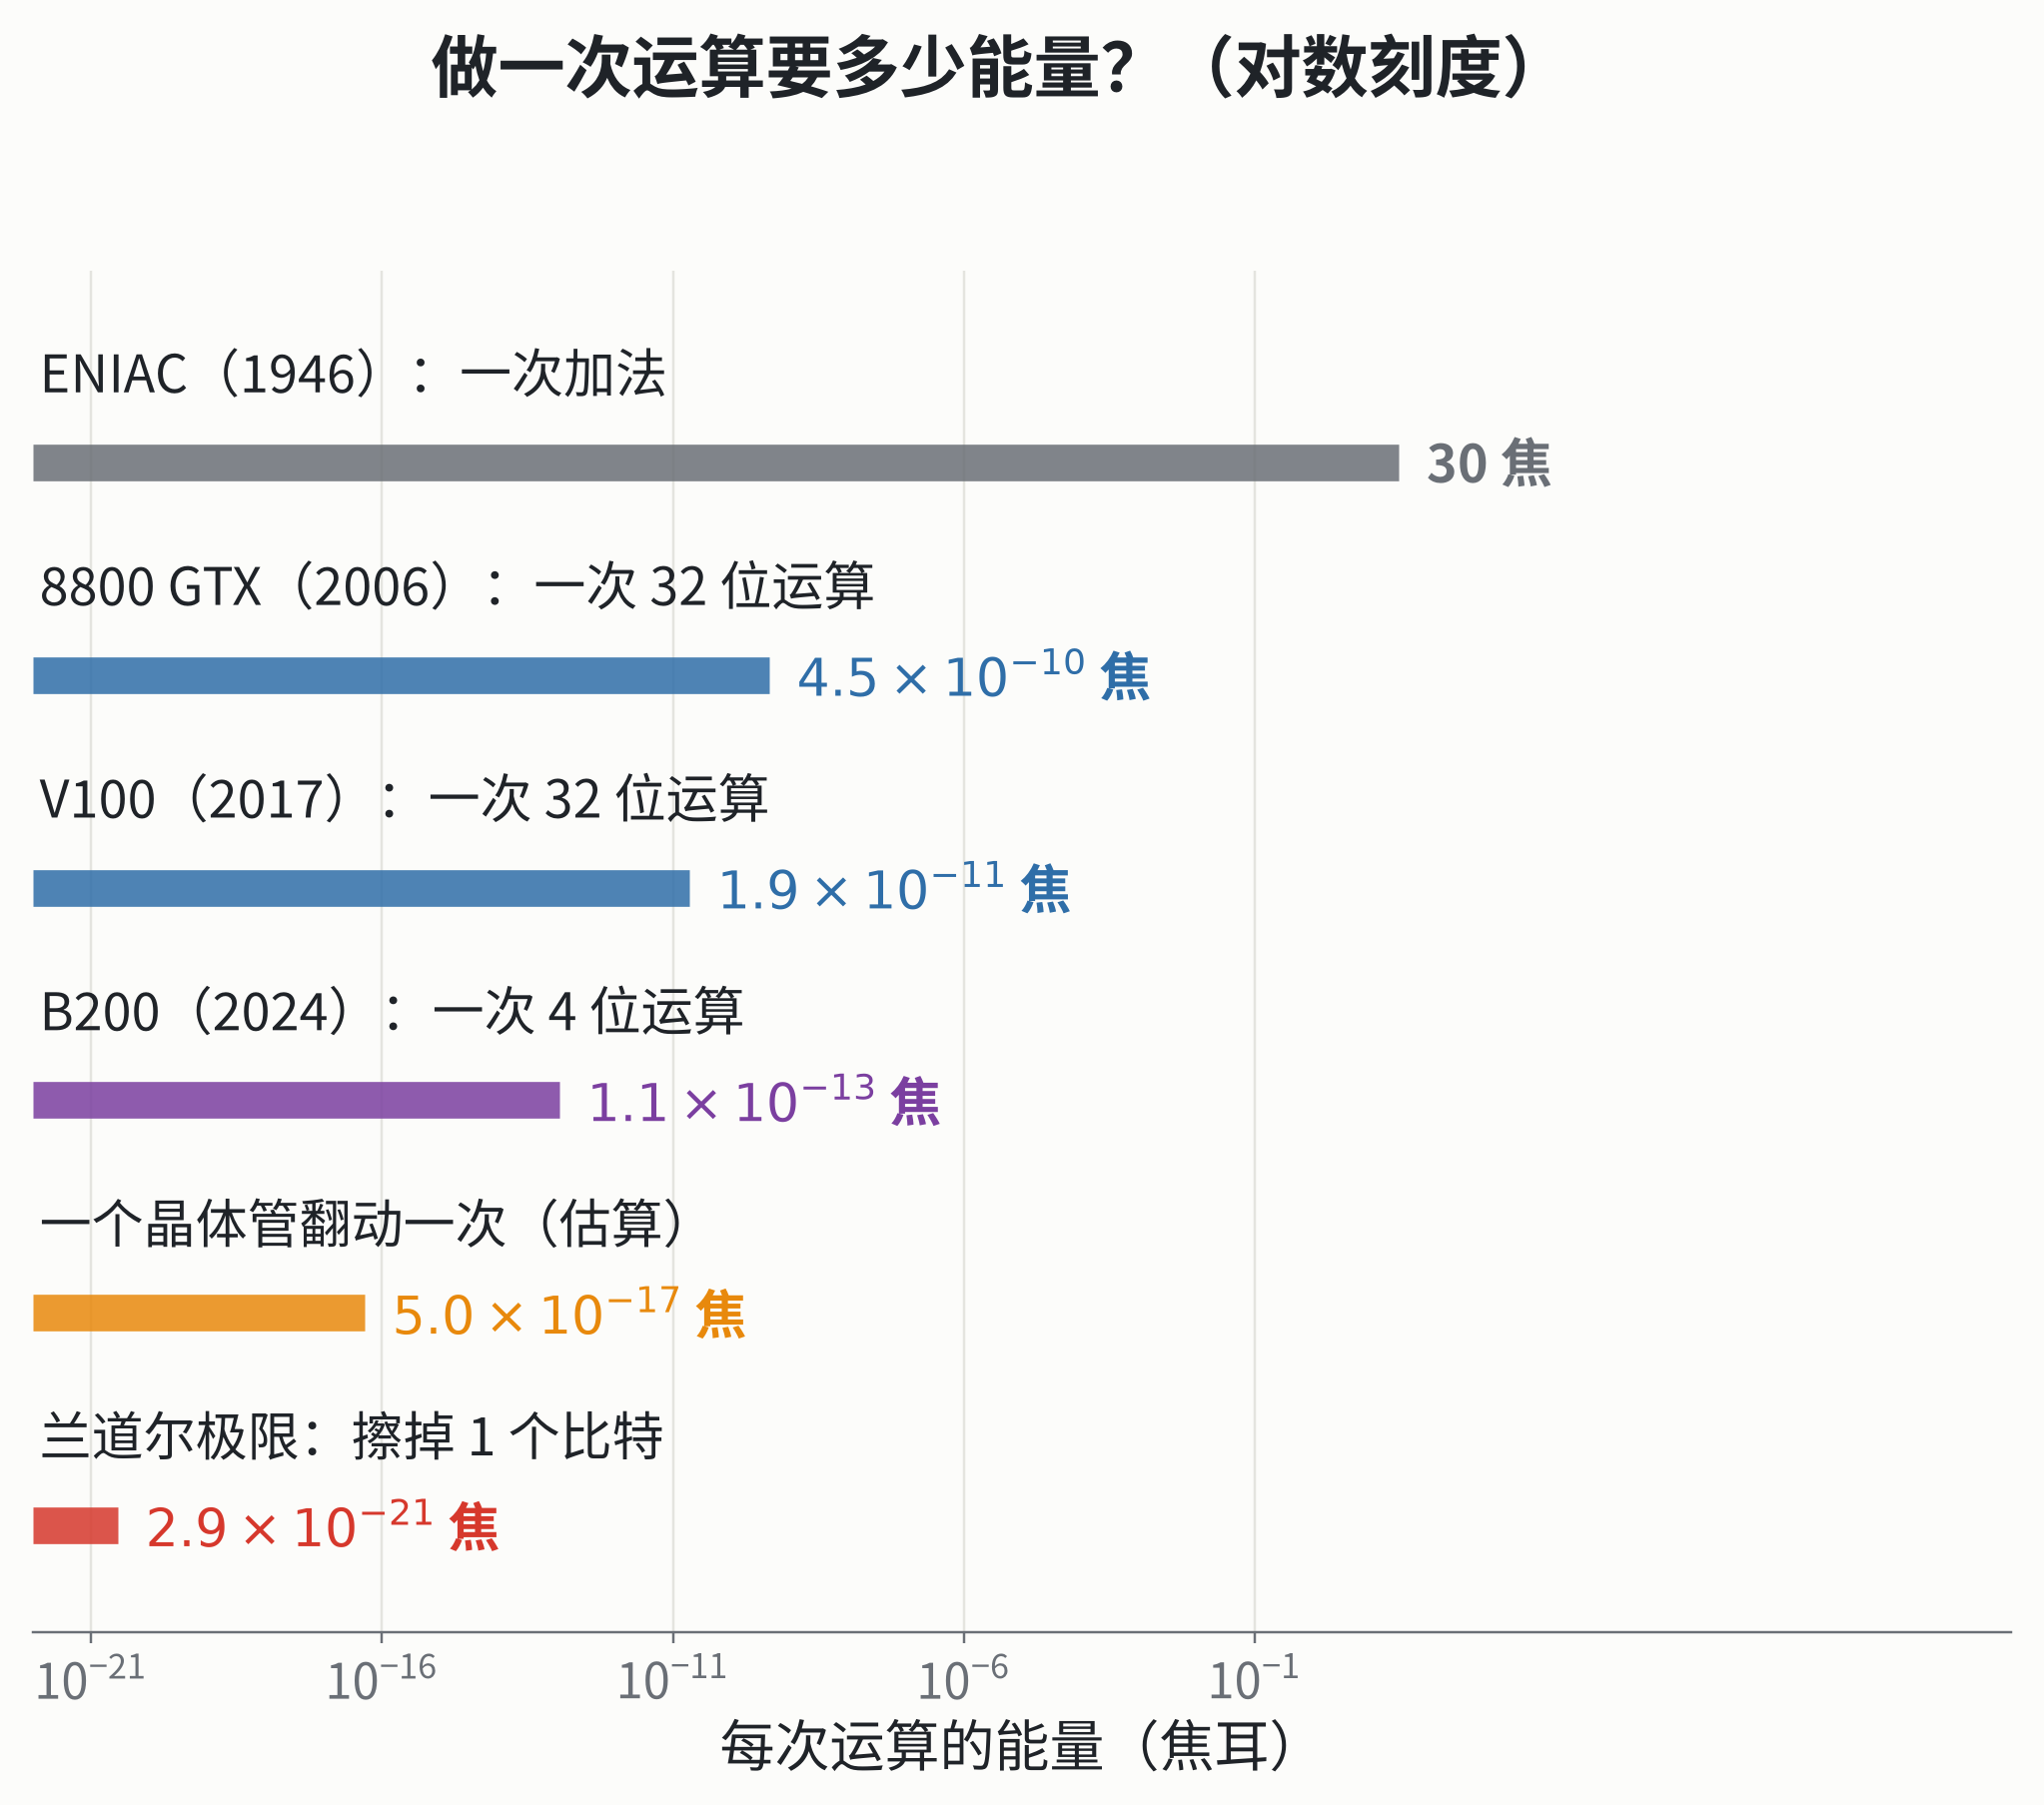
1946 年,第一台通用电子计算机 ENIAC 用了一万七千多个电子管,耗电约 150 千瓦,每秒做 5000 次加法,一次加法约 30 焦。今天的 GPU 做一次运算,能量少了约 倍。可离兰道尔极限,还差几千万倍:一次 4 位运算约 焦,是这个下限的约 倍;单是一个晶体管翻动一次,就已是这个下限的约 2 万倍。
这条下限只管「擦掉」。如果每一步都能倒着算回去、什么也不擦,原则上可以几乎不发热,这叫「可逆计算」。它离实用还很远,可它提醒我们:发热不是计算本身的代价,而是我们「忘记」的代价。
你手机里的这块芯片
手机里没有地方放好几块芯片,于是 CPU、GPU、专门做神经网络计算的「神经网络引擎」、管拍照的图像处理器,都做在同一块芯片上。拍照时的降噪、人像模式的背景虚化,就是 GPU 和神经网络引擎在几毫秒里把几千万个像素各自算一遍。
一句话:CPU 和 GPU 都是由开关组成的,开关每翻动一次都要发热,用掉的电最后几乎全变成热。2004 年前后,电压降不下去,频率就几乎不再上涨,芯片只好用更多的核心一起干活:CPU 只有几个又快又聪明的核心,擅长一步接一步地判断;GPU 有成千上万个简单的核心,擅长把同样的事同时做千万遍。画面的像素是这样,人工智能里的矩阵乘法也是这样,所以 GPU 从打游戏走到了今天的人工智能。
自己试一试
- 看看你的电脑有几个核心:Windows 打开「任务管理器」的「性能」页,苹果电脑打开「活动监视器」的「CPU」页,能看到每个核心各自忙不忙。
- 摸一摸:玩一会儿大型游戏或者连续拍视频,手机会发热。那就是几十亿个开关一通一断留下的热。
还不知道什么
晶体管还能缩小多少?今天的「3 纳米」只是工艺的名字,晶体管里最细的地方已经只有几十个原子宽,电子开始直接隧穿过去。工程师在试把芯片一层层叠起来、用光代替电来传数据。另一个问题是能量:一个大型的 AI 数据中心,用电可以抵得上一座城市,人工智能还能这样增长多久,取决于电从哪里来、热怎样散出去。
进阶:数字、公式和资料
开关的能量。给电容 充到电压 ,电源提供 的能量,一半存在电容里,一半在充电时变成热;放电时存的那一半也变成热。动态功耗 。登纳德缩放(Dennard 等,1974):尺寸、电压都缩小为 ,电容缩小为 ,频率可提高 倍,单个晶体管功耗缩小为 ,单位面积的晶体管多 倍,功率密度不变。
漏电。晶体管在门槛以下时,电流按 变化,理想情况 。室温 毫伏,电流变 10 倍要 毫伏,这是「亚阈值摆幅」的极限;真实的晶体管 略大于 1,约 70 到 100 毫伏。图 3 上半部分按理想情况画,示意用。
频率。1985 年的 386 是 16 MHz,2004 年的奔腾 4 是 3.8 GHz,涨了约 240 倍;2024 年的酷睿 i9-14900KS 最高 6.2 GHz,二十年只涨了约 1.6 倍。英特尔取消 4 GHz 奔腾 4 时没有给出技术原因;当时的 Prescott 奔腾 4 热设计功耗为 115 瓦。
每平方厘米的热。人体:静息约 100 瓦,体表约 1.8 平方米,约 0.0056 瓦每平方厘米。电炉炉盘:2000 瓦,直径 20 厘米,约 6.4。奔腾 4 Prescott:115 瓦,芯片面积 112 平方毫米,约 100。H100:700 瓦,芯片面积 814 平方毫米,约 86。太阳表面:, K,约 6300。光刻机一次曝光的最大面积约 26 × 33 毫米,即约 858 平方毫米,所以单块芯片最大约 8 平方厘米;B200、Rubin 都是两块这样大小的芯片封装在一起。
多核的账。频率和电压都乘 0.8,动态功耗乘 ;两个核心约 1.02 倍功耗,总吞吐约 1.6 倍。这里假设电压能和频率同比例降低、忽略漏电、任务能平分,都是理想情况。第一批双核的个人电脑芯片:英特尔 2005 年 4 月(奔腾至尊版 840),AMD 2005 年 5 月(速龙 64 X2)。
图 1。示意:CPU 4 个核心各 1 步完成 1 格,GPU 64 个核心各 4 步完成 1 格。1024 格时,CPU 256 步、GPU 64 步;32 步的依赖链,CPU 32 步、GPU 128 步。真实的 GPU 核心更多,单个核心和 CPU 核心的差距也因任务而异。
表里的数字。工艺:「3 纳米」「90 纳米」等是工艺代的名字;早期大致等于最小线宽,近二十年已不再对应实际尺寸。频率:发布时的型号范围或最高频率。CPU 的功耗是厂商标的热设计功耗。GPU 的「每秒运算」是厂商标的峰值,一次乘加按 2 次运算算;FP32 一栏,8800 GTX 为 ,GTX 580 为 ;B200 由 HGX B200 八卡系统的 600 TFLOPS 除以 8 得到。AI 低精度一栏取「稠密」值:V100 为张量核心 FP16;H100 SXM 为 FP8,B200 为 HGX B200(1000 瓦)的 FP4,厂商常写的是带稀疏加速的值,再大一倍;Rubin 为 FP4,取英伟达标明为稠密的训练值,它宣传的每秒 次是推理时借助数据压缩的值。B200 和 Rubin 都由两块芯片封装成一个 GPU。Rubin 的功耗英伟达未公布。A17 Pro 的晶体管数来自苹果的发布会;酷睿 i9-14900KS、EPYC 9965 的晶体管数厂商未公布。i9-14900KS 有 8 个性能核心和 16 个能效核心,6.2 GHz 是性能核心的最高加速频率。EPYC 9965 的计算部分用 3 纳米工艺,输入输出部分用 6 纳米。
一次滴答里的距离。3 GHz 时一次滴答 0.333 纳秒,光走 10.0 厘米;光在 1 纳秒里走 29.98 厘米(11.8 英寸),霍珀发的电线就是这么长。导线里电子的漂移速度 :电流密度 取芯片导线里很高的 安每平方米,铜的自由电子密度 每立方米, 毫米每秒。理想传输线上信号速度为 ,二氧化硅 ,约 (每毫米约 6.6 皮秒)。芯片上细导线的电阻大,是电阻和电容组成的「RC」线,不加中继时延迟约为 (、 是单位长度的电阻和电容),随长度的平方增长;加了中继后与长度成正比,文献给出的数值约每毫米 20 到 90 皮秒,即光速的约 4% 到 15%。从内存条读数据的延迟一般为几十到一百纳秒,主要花在内存芯片内部的操作上,不只是路程。
阿姆达尔定律。 时, 约快 15 倍, 最多 20 倍; 时,分别约 39 倍和 100 倍。
兰道尔极限。, K 时为 焦。图 5 里晶体管翻动一次按 估算,取 飞法、 伏,约 焦,约为兰道尔极限的 倍。GPU 每次运算的能量用整卡功耗除以峰值运算速度,只是数量级。ENIAC:17468 个电子管,约 150 千瓦,每秒 5000 次十位数加法。ENIAC 的十位十进制加法和 GPU 的 4 位运算并不等价,这里只比数量级。
换算。。 秒,约 49 天。。
资料。R. Landauer, IBM Journal of Research and Development 5, 183(1961)。A. Bérut 等,Nature 483, 187(2012)。ENIAC:H. Goldstine, Mathematical Tables and Other Aids to Computation 2, 97(1946)。霍珀的「纳秒」:美国国家历史博物馆藏品。G. Amdahl, AFIPS 1967。R. Dennard 等,IEEE Journal of Solid-State Circuits SC-9, 256(1974)。英特尔取消 4 GHz 奔腾 4:路透社,2004 年 10 月 14 日。英特尔酷睿 i9-14900KS:英特尔 2024 年 3 月 14 日的发布资料。2024 年诺贝尔物理学奖:nobelprize.org。导线延迟:ITRS 路线图及片上全局互连的研究文献。AlexNet:Krizhevsky、Sutskever、Hinton,NeurIPS 2012。GPU 规格:英伟达 GeForce 256、8800 GTX、GTX 580 产品资料,V100、H100 数据手册,HGX 平台页面(B200、Rubin)。Rubin 出货:英伟达 2026 年 11 月的季度财报。苹果 A17 Pro:苹果 2023 年 9 月 12 日发布会。AMD EPYC 9965:AMD 2024 年 10 月的发布资料。